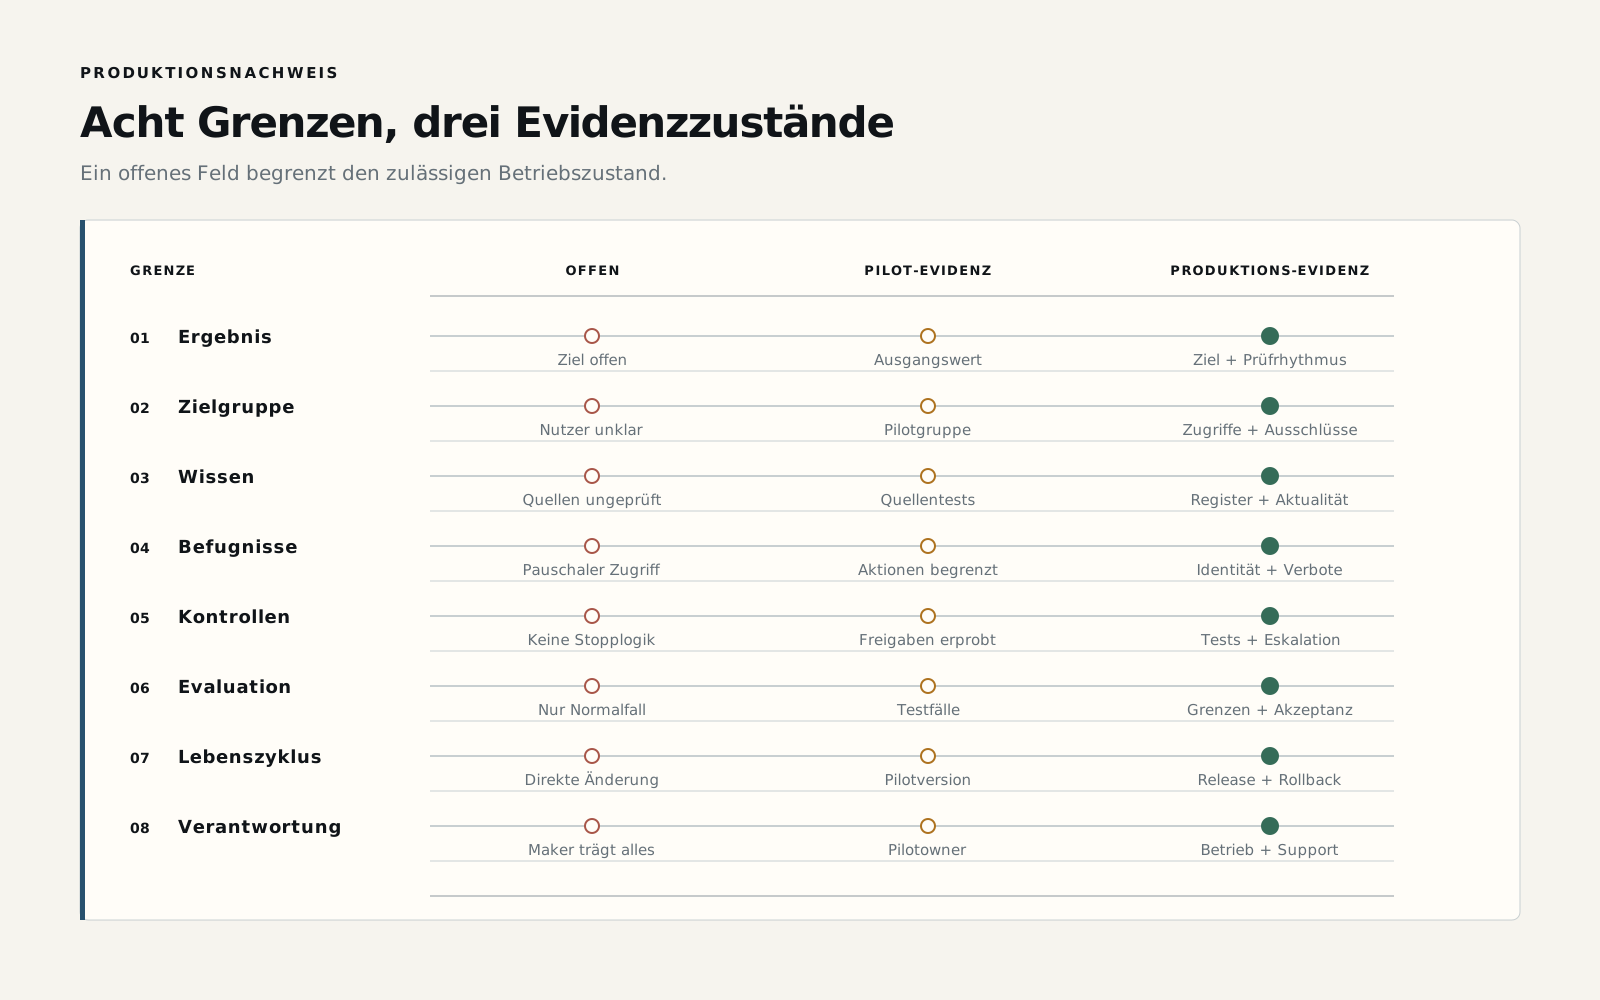
Eine erfolgreiche Demo zeigt, dass ein Agent eine ausgewählte Aufgabe unter günstigen Bedingungen bearbeiten kann. Sie zeigt nicht, dass die Organisation ihn verlässlich betreiben kann. Vor dem Produktivstart müssen acht Grenzen feststehen: Ergebnis, Zielgruppe, Wissen, Befugnisse, Kontrollen, Evaluation, Lebenszyklus und Verantwortung. Bleibt eine davon implizit, kann der Agent nützlich sein, ist aber noch kein verantworteter Produktivdienst.
Die Demo prüft Fähigkeiten, der Betrieb prüft Verantwortung
Bei Prototypen stehen meist Antwortqualität, Orchestrierung und Werkzeugnutzung im Mittelpunkt. Im Betrieb kommen andere Fragen hinzu: Wer ist betroffen, wenn eine Antwort falsch ist? Mit welcher Identität wird eine Aktion ausgeführt? Was geschieht bei einer ausgefallenen oder widersprüchlichen Quelle? Wer erhält eine Warnung, genehmigt Änderungen, bearbeitet einen Incident oder stoppt den Dienst?
Microsofts Gestaltungsrahmen behandelt Ziele, Auslöser, Daten, Werkzeuge, Governance und Evaluation. Die Betriebs-Checkliste ergänzt getrennte Umgebungen, Datenrichtlinien, Monitoring, Application Lifecycle Management und benannte Verantwortliche. Die übertragbare Erkenntnis lautet: Ein Agent ist erst produktionsreif, wenn sein Verhalten in ein belastbares Betriebsmodell eingebettet ist.
Prototypen verbergen häufig günstige Annahmen. Der Maker kennt die erwartete Formulierung. Testdaten sind sauber, Berechtigungen großzügig und der Normalfall erhält die meiste Aufmerksamkeit. In Produktion verschwinden diese Schutzbedingungen. Nutzer stellen mehrdeutige Fragen, Quellsysteme fallen aus, Verantwortliche wechseln und kleine Änderungen beeinflussen das Verhalten.
Acht Grenzen vor der Freigabe dokumentieren
Der Produktionsnachweis sollte auf eine Seite passen. Er soll nicht alles dokumentieren, sondern die Entscheidungen sichtbar machen, die Exposition, Nachweis und Verantwortung bestimmen.
| Grenze | Zu dokumentierende Entscheidung | Nachweis vor Produktion |
|---|---|---|
| Ergebnis | Welches betriebliche Ergebnis soll sich verändern? | Ausgangswert, Zielgröße und Prüfrhythmus |
| Zielgruppe | Wer darf den Agenten nutzen und wer ist betroffen? | Zugriffsgruppen, Ausschlüsse und Betroffenenanalyse |
| Wissen | Welche Quellen sind erlaubt und wie aktuell müssen sie sein? | Quellenregister, Berechtigungstests und Verhalten bei veralteten Inhalten |
| Befugnisse | Was darf der Agent lesen, empfehlen, erstellen, ändern oder senden? | Werkzeugrechte, handelnde Identität und verbotene Aktionen |
| Kontrollen | Wo sind Validierung, Freigabe, Eskalation und Stopp nötig? | Kontrolltests und benannte Eskalationswege |
| Evaluation | Welche normalen, mehrdeutigen und adversarialen Fälle müssen bestehen? | Testmenge, Akzeptanzgrenzen und bekannte Einschränkungen |
| Lebenszyklus | Wie werden Versionen gebaut, getestet, freigegeben und zurückgenommen? | Umgebungsstrategie, Abhängigkeiten und Rollback-Verfahren |
| Verantwortung | Wer verantwortet Wert, Betrieb, Risiko und Support? | Benannte Rollen, Prüftermine und Incident-Aufgaben |
Ein offenes Feld bedeutet nicht automatisch einen Stopp. Es verlangt eine ehrliche Einordnung. Ein Experiment darf offene Produktionsfragen enthalten, wenn Zielgruppe, Daten und Folgen eng begrenzt sind. Ein produktiver Dienst darf das nicht.
Befugnisse verändern das Risiko am stärksten
Ein Agent, der Dokumente zusammenfasst, erzeugt andere Risiken als ein Agent, der Nachrichten versendet, Datensätze verändert oder einen Browser bedient. Befugnisse werden deshalb mit Verben beschrieben und nicht mit der vagen Aussage, der Agent habe Zugriff.
“Zugriff auf das Service-Management-System” ist unvollständig. Eine brauchbare Beschreibung lautet: Der Agent darf Tickets lesen, die dem aktuellen Nutzer zugeordnet sind, eine interne Notiz entwerfen und eine Kategorie vorschlagen. Er darf kein Ticket schließen, keine Priorität ändern, keinen Antragsteller kontaktieren und keine fremde Queue ohne Freigabe lesen.
Diese Präzision hilft Engineering und Governance zugleich. Entwickler kennen Identitäten und Werkzeuge. Security kann minimale Rechte prüfen. Der Betrieb definiert Warnungen. Der fachliche Eigentümer entscheidet, ob der verbleibende manuelle Schritt akzeptabel ist.
Kontrollen gehören dorthin, wo Unsicherheit auf Folgen trifft
Nicht jede Modellausgabe braucht menschliche Freigabe. Nicht jede Agentenaktion darf automatisch erfolgen. Feste Validierung prüft Fakten und Regeln, die ein Modell nicht schätzen sollte, etwa Pflichtfelder, Kennungen, Summen, zulässige Empfänger oder Richtlinienschwellen.
Menschliche Prüfung gehört dorthin, wo Interpretation nötig bleibt und ein Fehler relevante Folgen hätte. Irreversible, rechtlich bedeutsame oder extern sichtbare Aktionen brauchen eine stärkere Grenze als ein umkehrbarer interner Entwurf. Manche Aktionen bleiben verboten, wenn das Risiko mit den verfügbaren Kontrollen nicht ausreichend begrenzt werden kann.
Ziel ist nicht maximale Automation, sondern die kleinste menschliche Beteiligung, die verantwortliches Urteil erhält.
Das System evaluieren, nicht nur das Gespräch
Tests der Antwortqualität sind notwendig, aber unvollständig. Eine Produktionsevaluation umfasst Berechtigungsgrenzen, Quellausfälle, nicht verfügbare Werkzeuge, schädliche Anweisungen, doppelte Aktionen, lange Aufgaben und Wiederanlauf nach Unterbrechung.
Das erwartete Ergebnis ist nicht immer eine richtige Antwort. Es kann eine Ablehnung, Rückfrage, Eskalation oder ein sicherer Stopp sein. Diese Verhaltensweisen benötigen eigene Testfälle, weil Nutzer sie als Teil des Dienstes erleben.
Evaluation endet nicht mit der Freigabe. Beobachtet werden Werkzeugaufrufe, Fehler, Wiederholungen, Latenz, Nutzerfeedback, Korrekturen und betriebliche Ergebnisse. Ein bestandener Test beweist nicht, dass Quellen, Nutzungsmuster und Abhängigkeiten stabil bleiben.
Beispiel einer Freigabeentscheidung
Ein Agent soll eingehende Supportanfragen bearbeiten. In der Demo liest er eine E-Mail, erkennt die Kategorie und entwirft eine Antwort. Das Team schlägt automatisches Versenden vor.
Der Produktionsnachweis zeigt drei offene Grenzen. In der Kundendatenbank existieren ähnliche Firmennamen, einige Kategorien unterliegen vertraglichen Reaktionszeiten und die Wissensquelle enthält veraltete Anweisungen. Automatisches Senden würde Unsicherheit mit externer Wirkung verbinden.
Ein vertretbarer Pilot lässt den Agenten klassifizieren, freigegebene Hinweise abrufen und einen Entwurf erstellen. Feste Prüfungen validieren Kundenkennung und Pflichtfelder. Ein Supportmitarbeiter prüft vor dem Versand. Gemessen werden Klassifikationsqualität, Änderungsumfang, Bearbeitungszeit und Eskalationsgründe. Automatischer Versand wird erst bei ausreichender Evidenz neu bewertet.
Das ist keine gescheiterte Automation. Es ist ein bewusst begrenzter Dienst, der Nachweise für die nächste Entscheidung erzeugt.
Drei Zustände statt einer binären Startentscheidung
Experiment: Das Lernen steht im Vordergrund. Genutzt werden synthetische oder risikoarme Daten, eine kleine Expertengruppe, keine folgenreiche autonome Aktion und ein festes Enddatum.
Begrenzter Pilot: Reale Arbeit findet innerhalb einer definierten Zielgruppe und Befugnis statt. Verantwortliche, Monitoring und Nachweise für eine Erweiterung sind benannt.
Produktivdienst: Der Betrieb verfügt über freigegebene Kontrollen, Lebenszyklus, Support, Monitoring, Incident-Verfahren und regelmäßige Prüfung.
Der Zustand muss für Nutzer und Prüfer sichtbar sein. Ein Pilot darf nicht als Produktion bezeichnet werden. Umgekehrt darf das Wort Experiment keine reale betriebliche Exposition verschleiern.
Typische Fehlentwicklungen
Am häufigsten wird die Demo-Architektur durch Gewohnheit zur Produktionsarchitektur. Weitere Warnsignale sind gemeinsam genutzte Maker-Zugänge, zu breite Konnektoren, fehlende Ausgangswerte für den Nutzen, Quellen ohne Eigentümer, direkte Änderungen in Produktion und Monitoring, das Gespräche zählt, aber keine Fehler oder Ergebnisse.
Problematisch ist auch eine Governance-Prüfung erst nach dem Build. Späte Kontrolle führt häufig zu Umbau, weil Identitäts-, Umgebungs- oder Datenentscheidungen bereits fest verankert sind. Der Produktionsnachweis beginnt deshalb vor der Implementierung und reift mit dem Agenten.
Die abschließende Freigabefrage
Ein Agent ist produktionsreif, wenn das Team sein erlaubtes Verhalten erklären, repräsentative Tests nachweisen, Verantwortliche benennen und den Umgang mit Änderungen, Incidents und Kapazität zeigen kann. Die Antwort kann weiterhin “noch nicht” lauten. Das ist ein nützliches Ergebnis, wenn der fehlende Nachweis und der nächste begrenzte Schritt klar sind.
Amplified Pi verbindet mit dem Acht-Grenzen-Modell KI-Strategie und Umsetzung. Wir helfen bei Musterauswahl, Bau, Evidenz und risikogerechtem Betrieb. Der sinnvolle nächste Schritt ist die gemeinsame Prüfung eines realen Agenten und keine weitere allgemeine Reifeumfrage.